


Table of Contents
Une catégorie d’outils d’IA en pleine expansion ne mesure plus directement les personnes. Au lieu de cela, ces systèmes prédisent le comportement humain à partir du contenu lui-même. Plutôt que de suivre le regard ou les réactions faciales d’une personne réelle, ils évaluent quelle sera probablement cette réaction.
Cette évolution peut s’avérer extrêmement utile. Elle permet d’accélérer les tests, de les rendre moins coûteux et plus faciles à adapter à grande échelle. Mais elle modifie également la source de la confiance. Lorsqu’il n’y a pas de véritable participant au processus, un modèle ne dispose que d’un seul lien avec la réalité : les données annotées par des humains à partir desquelles il a appris.
À mesure que l’IA prédictive se généralise, le besoin de jeux de données humains volumineux, variés et de haute qualité ne disparaît pas. Dans de nombreux cas, il devient même encore plus important. Les organisations qui disposent des meilleures données de référence pourraient bien détenir l’avantage le plus important à long terme.
La prévision remplace la mesure
Pendant la majeure partie de son histoire, la recherche comportementale s’est appuyée sur l’observation de personnes réelles. Les chercheurs recrutaient des participants, enregistraient leur comportement et analysaient les résultats à l’échelle d’un échantillon.
Aujourd’hui, de nombreux systèmes d’IA fonctionnent différemment. Au lieu d’évaluer une personne, ils prédisent ce qu’elle est susceptible de faire.
Vous pouvez mettre en ligne une publicité et obtenir une estimation de l’attention qu’elle suscitera. Certains systèmes évaluent l’engagement du public sans montrer le contenu à un seul participant.
Des approches similaires existent désormais pour l’oculométrie, les réactions faciales et d’autres formes de comportement.
L’intérêt est évident. Une étude qui prenait autrefois des semaines ne prend désormais que quelques minutes. Il est possible d’examiner des centaines de concepts créatifs avant de lancer un seul projet de recherche.
Mais la prédiction et la mesure ne sont pas la même chose. Lorsque l’on cesse de collecter de nouvelles données, la qualité de la prédiction dépend presque entièrement de la qualité des données utilisées pour entraîner le modèle.
Règle générale : la qualité d’une prédiction dépend de celle de ses données de référence
En apprentissage automatique, la « vérité de référence » désigne les données vérifiées à partir desquelles un modèle apprend et sur lesquelles il est testé. En termes simples, il s’agit de la réponse correcte à laquelle le modèle tente de faire correspondre ses « réponses ». En IA comportementale, la vérité de référence provient de personnes réelles. Elle inclut les directions du regard des personnes, les mouvements de leur visage et les réactions du public.
Lorsqu’un système mesure un comportement, il reste ancré dans la réalité. Ce sont de vraies personnes qui génèrent les données en temps réel. Un système prédictif fonctionne différemment : il élabore une réponse à partir de tendances identifiées dans des données humaines passées. Aucun participant n’est présent pour corriger les erreurs ou signaler les failles du modèle.
C’est pourquoi la prédiction dépend fortement des données de référence. Si les données sont limitées, biaisées, obsolètes ou inexactes, la prédiction reflétera ces faiblesses.
Cela nous amène à une règle simple : moins un modèle effectue de mesures, plus il dépend des données humaines sur lesquelles il a été construit. L’humain ne disparaît jamais du processus. Les données se situent simplement plus en amont.
Cas n° 1 : Attention prévue
L’eye tracking prédictif permet d’estimer les endroits vers lesquels les personnes sont susceptibles de diriger leur regard sans mesurer le comportement réel des spectateurs. Cela rend cette méthode rapide, évolutive et peu coûteuse. Mais cela soulève également une question importante : comment le modèle sait-il où les personnes vont regarder ?
La réponse est que l’IA s’est entraînée à partir de données réelles d’oculométrie recueillies auprès de personnes réelles. Et la qualité de ses prédictions dépend de la qualité de ces données.
Les tests de référence propres à ce domaine permettent de comprendre pourquoi. Des ensembles de données courants, tels que MIT300 et CAT2000, contiennent entre quelques centaines et quelques milliers d’images observées par de petits groupes de participants à l’aide d’oculomètres en laboratoire. Un modèle peut obtenir des résultats impressionnants sur ces tests de référence tout en rencontrant des difficultés face à une publicité, un emballage de produit ou un site web spécifiques.
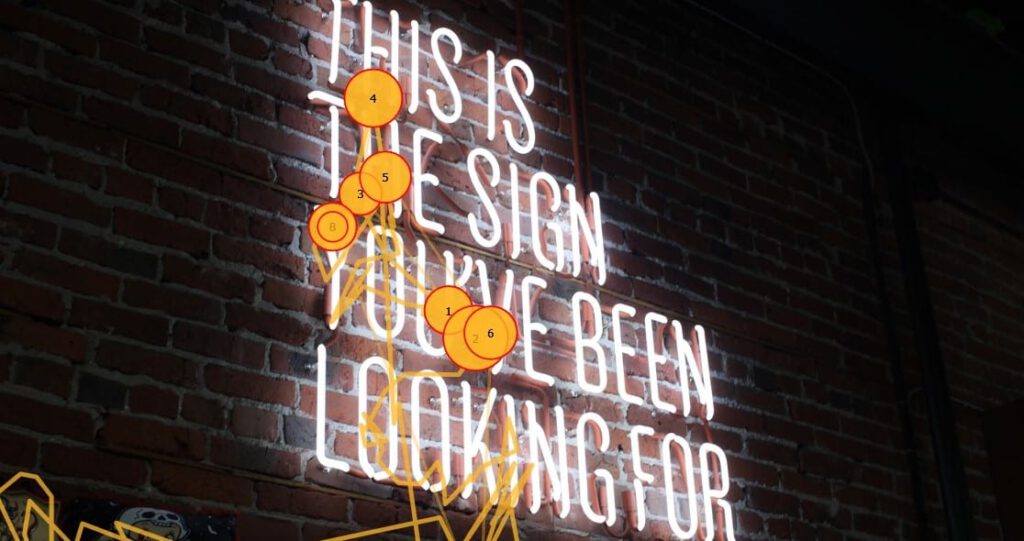
La raison en est simple. Les images contenues dans ces ensembles de données sont souvent très différentes du contenu que les entreprises souhaitent tester. Les tâches sont également différentes. Une personne qui regarde une photo de manière informelle ne fait pas la même chose qu’un acheteur qui compare des produits ou qu’un client qui tente de finaliser un achat.
La même tendance se retrouve dans les données d’entraînement. SALICON, l’un des ensembles de données de saillance les plus utilisés, a été étendu à des dizaines de milliers d’images en utilisant un indicateur de l’attention visuelle basé sur les mouvements de la souris plutôt que l’oculométrie traditionnelle. Bien que les données d’attention issues de la souris soient souvent en corrélation avec le comportement du regard, des études comparant les données de souris et celles issues de l’oculométrie ont montré que le choix de la « vérité de référence » influence à la fois les schémas capturés dans l’ensemble de données et le comportement des modèles entraînés à partir de celui-ci.
En d’autres termes, ce domaine a gagné en envergure grâce à l’utilisation d’un indicateur de substitution. Ce compromis a permis de disposer d’ensembles de données plus volumineux, mais n’a pas supprimé la nécessité de disposer de véritables données d’oculométrie. Il a simplement déplacé ce besoin plus en amont.
La leçon à en tirer est simple : plus les données de référence fournies par l’homme sont fiables, meilleures sont les prévisions.
Cas n° 2 : engagement prévu du public, où la « vérité de référence » correspond à l’ensemble du produit
Cette tendance apparaît encore plus clairement dans la prévision de l’engagement du public.
Traditionnellement, l’engagement se mesure en recrutant des spectateurs, en leur présentant du contenu et en analysant leurs réactions faciales à chaque instant. Les modèles prédictifs d’engagement adoptent une approche différente : ils estiment cette réaction directement à partir du contenu lui-même, ce qui permet de tester une création avant même qu’un seul nouveau participant ne soit recruté.
L’intérêt est, là encore, évident. Tout comme la dépendance vis-à-vis des données. Si le modèle n’observe jamais un nouveau public, tout ce qu’il sait du comportement de ce dernier doit provenir des publics qu’il a déjà observés.
Ce qui rend ce cas particulièrement intéressant, c’est que la « ground truth » et l’avantage concurrentiel constituent un seul et même atout. Le corpus d’Affectiva, constitué au fil de plus d’une décennie, regroupe plus de 100 000 publicités, plus de 18 millions d’enregistrements faciaux et des milliards d’images vidéo provenant d’environ 90 pays. Point essentiel : ses étiquettes ne proviennent pas d’un substitut bon marché.
Ils s’appuient sur le Facial Action Coding System (FACS), dans le cadre duquel des codeurs humains qualifiés annotent, image par image, les mouvements spécifiques des muscles faciaux : ce travail minutieux et spécialisé, réalisé par des experts, constitue le fondement des modèles considérés comme la référence absolue en matière de codage facial automatisé.
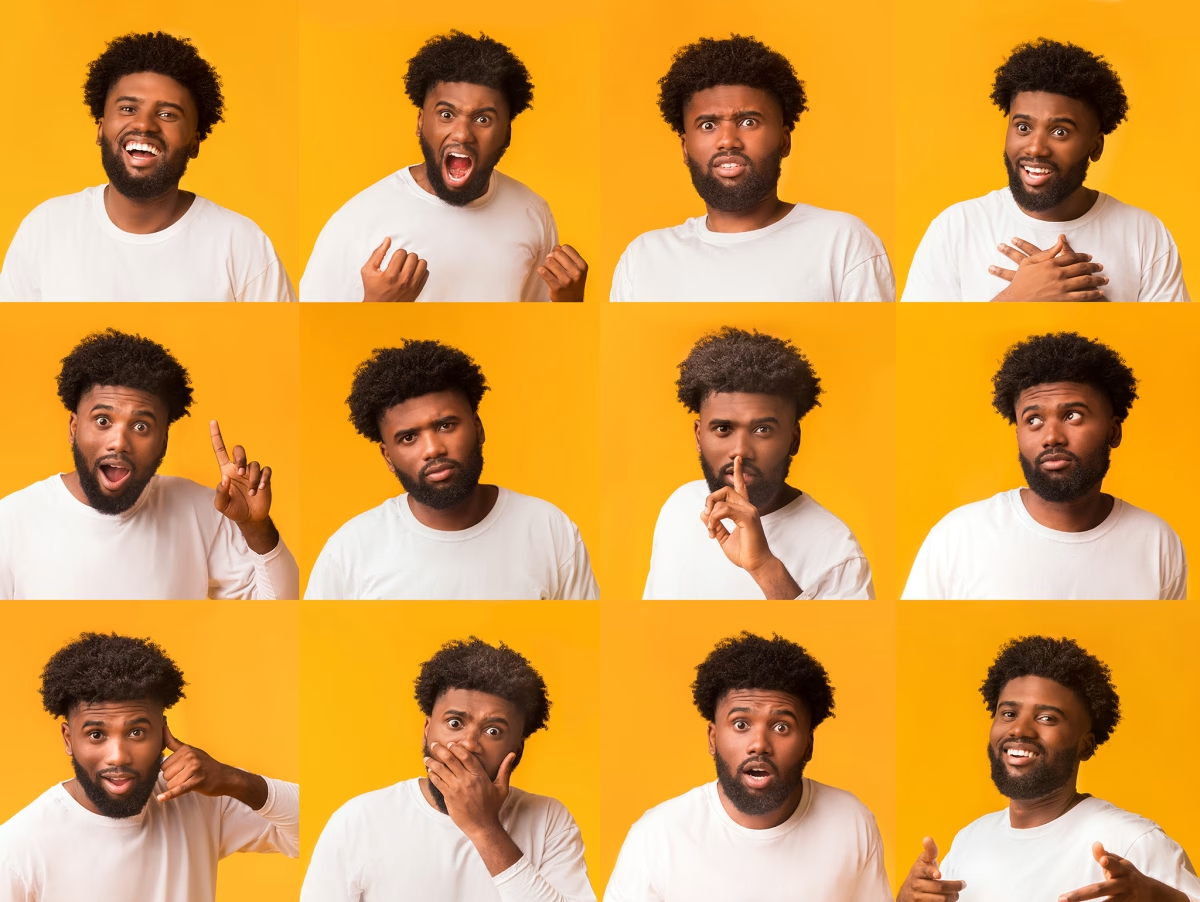
Un modèle prédictif d’engagement entraîné sur ces archives constitue, au sens le plus littéral du terme, une synthèse d’une quantité colossale de réactions humaines soigneusement étiquetées. Sa crédibilité repose sur ce corpus.
C’est là l’illustration la plus claire qui soit de ce principe général : le modèle prédictif n’entre en contact avec aucun nouveau spectateur ; par conséquent, tout ce qu’il sait sur l’engagement humain, il le doit au fait que des humains ont été évalués et qu’des experts humains les ont classés. L’échelle, la diversité et la rigueur du classement ne sont pas de simples atouts supplémentaires. Elles constituent le fondement même de la confiance.
À quoi ressemble une « bonne » donnée de référence ?
À ce stade, une question s’impose naturellement : qu’est-ce qui distingue un modèle prédictif digne de confiance d’un autre qui semble simplement convaincant ?
La réponse ne réside pas dans un simple score de référence ou dans la taille d’un ensemble de données. Qu’il s’agisse de différents types d’IA prédictive, les mêmes qualités reviennent sans cesse.
Tout d’abord, rien ne peut remplacer les données humaines réelles. Les mesures indirectes peuvent être utiles, et sont parfois nécessaires pour atteindre une certaine échelle, mais elles ne restent que des substituts. Un modèle entraîné à partir des mouvements de souris n’est pas comparable à un modèle entraîné à partir de données réelles sur le regard. Un modèle entraîné à partir de labels générés automatiquement n’est pas comparable à un modèle entraîné à partir d’un comportement humain soigneusement codé. En matière de validation, la réalité reste ce qui compte le plus.
L’échelle a aussi son importance, mais uniquement lorsqu’elle s’accompagne de diversité. Un ensemble de données peut contenir des millions d’observations et ne pas pour autant représenter les personnes que le modèle est censé prédire. L’objectif n’est pas simplement d’avoir plus de données. L’objectif est d’avoir des données plus variées. La diversité des cultures, des tranches d’âge, des contextes et des types de contenu aide le modèle à apprendre un éventail plus large de comportements humains.
La qualité des étiquettes est tout aussi importante que la quantité des données. Dans de nombreux domaines liés au comportement, les étiquettes constituent en effet la définition même de ce qu’est une « réponse correcte ». Un ensemble de données basé sur le FACS est précieux non seulement parce qu’il est volumineux, mais aussi parce que des codeurs humains qualifiés ont passé des années à créer un point de référence cohérent et fiable.
Les données doivent également refléter l’environnement dans lequel le modèle sera utilisé. Un modèle entraîné sur des images génériques peut obtenir de bons résultats lors des tests de performance, mais rencontrer des difficultés avec les publicités, les sites web, les emballages de produits ou d’autres contenus issus du monde réel. Les données de référence issues du domaine cible sont souvent plus utiles qu’un ensemble de données beaucoup plus volumineux provenant d’ailleurs.
L’objectif lui-même doit également être mesurable. Il existe une différence importante entre prédire un engagement observable et prétendre déchiffrer l’état émotionnel intime d’une personne. Plus un modèle reste proche d’éléments observables, mesurables et vérifiables, plus ses fondements sont solides.
Enfin, il y a la question du temps. La nature humaine ne change pas du jour au lendemain, contrairement à l’environnement médiatique. Les plateformes évoluent. Les styles créatifs changent. De nouvelles formes de contenu apparaissent. Un modèle entraîné sur la base du monde d’hier peut peu à peu s’éloigner de celui d’aujourd’hui, à moins que ses données de référence ne soient mises à jour au fil du temps.
Prises dans leur ensemble, ces caractéristiques mènent à une conclusion simple : la valeur d’un modèle prédictif dépend de la qualité de la réalité humaine qui le sous-tend.
Et cela crée un paradoxe intéressant. Plus l’IA prédictive se généralise, plus la « vérité de terrain » humaine prend de l’importance.
Plus nous faisons de prévisions, plus nous avons besoin de la vérité humaine
Prenez un peu de recul, et vous verrez se dessiner une tendance claire. Plus la prédiction remplace la mesure, plus l’ensemble du système dépend de données collectées et étiquetées par l’homme.
Cette dépendance apparaît à au moins trois endroits.
Le premier est l’apprentissage. Chaque nouveau public, chaque nouvelle plateforme, chaque nouveau type de contenu ou chaque nouvelle approche de mesure nécessite à terme de nouvelles données humaines. Les modèles peuvent très bien généraliser, mais ils ne peuvent pas généraliser indéfiniment. Un modèle entraîné sur des images statiques ne vous mènera pas très loin dans le domaine de la vidéo. Un modèle entraîné dans un contexte culturel donné ne comprendra pas automatiquement un autre contexte. À un moment donné, de nouvelles données humaines doivent être intégrées au système.
Le deuxième aspect est la validation. Un score de référence peut montrer qu’un modèle fonctionne dans un certain contexte, mais il ne permet guère de savoir s’il est adapté à votre public ou à votre contenu. Pour répondre à cette question, il faut encore analyser des personnes réelles et comparer les prédictions à la réalité. Tout effort de validation sérieux établit une nouvelle « vérité terrain » précisément là où le modèle est censé être utilisé.
Le troisième concerne les domaines dans lesquels les systèmes prédictifs peinent encore. Les différences interculturelles. L’attention orientée vers une tâche. Le contenu dynamique. La relation complexe entre le comportement observable et les états émotionnels internes. Bon nombre des plus grands défis de ce domaine trouvent leur origine dans des données de terrain limitées, contestées ou incomplètes. Et bon nombre des meilleures solutions impliquent la collecte de données humaines plus riches et plus représentatives.
Malgré toute l’attention accordée aux algorithmes, c’est cette dépendance qui importe le plus. L’automatisation du résultat ne rend pas superflue la vérité humaine. Elle en renforce la valeur.
Plus l’IA prédictive gagne en efficacité, plus les données de référence de haute qualité qui l’accompagnent prennent de la valeur.
Dans un domaine fondé sur la prédiction, les ensembles de données humaines les plus approfondis, les plus complets et les mieux annotés ne constituent pas simplement un coût inhérent à l’activité. Ils constituent le fondement sur lequel repose le système et représentent souvent un avantage que les concurrents ne peuvent pas facilement reproduire.
Un argument pratique, mais une véritable dépendance
Il est juste de souligner que cet argument arrange les entreprises, telles qu’iMotions, qui collectent et classent des données sur le comportement humain. Cela les arrange, mais cela ne signifie pas pour autant qu’il soit erroné.
Cette dépendance est structurelle, et non commerciale. Un modèle prédictif qui ne mesure jamais un participant réel ne dispose que d’une seule source de vérité : les données humaines sur lesquelles il a été entraîné et testé. Cette vérité ne peut provenir d’aucune autre source.
Au contraire, les critiques telles que celles de Barrett ne font que renforcer cet argument. Si le comportement humain varie davantage d’une culture à l’autre, d’un contexte à l’autre et d’un individu à l’autre que nous ne le pensions auparavant, alors la qualité des données sous-jacentes revêt une importance encore plus grande.
La solution ne consiste pas à réduire la quantité de données de référence, mais à améliorer leur qualité. Elles doivent être plus complètes, plus variées, plus représentatives et étiquetées avec plus de soin.
Les intérêts en jeu et l’argument peuvent aller dans le même sens. Cela ne prouve pas la validité de l’argument. Mais cela ne l’affaiblit pas non plus.
Cette dépendance existe, que cela soit ou non avantageux d’un point de vue commercial.
La prédiction peut automatiser la mesure, mais elle ne peut pas automatiser la réalité dont cette mesure est issue.