


Table of Contents
Eine wachsende Gruppe von KI-Tools misst Menschen nicht mehr direkt. Stattdessen sagen diese Systeme menschliches Verhalten anhand der Inhalte selbst voraus. Anstatt den Blick oder die Gesichtsreaktion einer realen Person zu verfolgen, schätzen sie ein, wie diese Reaktion wahrscheinlich ausfallen wird.
Diese Umstellung kann unglaublich nützlich sein. Sie macht das Testen schneller, kostengünstiger und leichter skalierbar. Aber sie verändert auch, woher das Vertrauen stammt. Wenn kein echter Teilnehmer am Prozess beteiligt ist, hat ein Modell nur eine einzige Verbindung zur Realität: die von Menschen annotierten Daten, anhand derer es trainiert wurde.
Auch mit der zunehmenden Verbreitung prädiktiver KI bleibt der Bedarf an umfangreichen, vielfältigen und qualitativ hochwertigen Datensätzen menschlicher Herkunft bestehen. In vielen Fällen gewinnt er sogar noch an Bedeutung. Die Organisationen, die über die besten „Ground-Truth“-Daten verfügen, könnten langfristig den größten Vorteil haben.
Vorhersagen ersetzen Messungen
Während des größten Teils ihrer Geschichte stützte sich die Verhaltensforschung auf die Beobachtung realer Menschen. Die Forscher rekrutierten Teilnehmer, zeichneten deren Verhalten auf und analysierten die Ergebnisse anhand einer Stichprobe.
Heutzutage funktionieren viele KI-Systeme anders. Anstatt eine Person zu bewerten, sagen sie voraus, was diese Person wahrscheinlich tun wird.
Sie können eine Anzeige hochladen und eine Prognose darüber erhalten, worauf die Aufmerksamkeit gerichtet sein wird. Einige Systeme schätzen das Engagement der Zielgruppe, ohne den Inhalt auch nur einem einzigen Teilnehmer zu zeigen.
Ähnliche Ansätze gibt es mittlerweile auch für Eye-Tracking, Gesichtsreaktionen und andere Verhaltensformen.
Der Reiz liegt auf der Hand. Eine Untersuchung, die früher Wochen dauerte, lässt sich nun in wenigen Minuten durchführen. Hunderte kreativer Konzepte können geprüft werden, bevor ein einziges Forschungsprojekt gestartet wird.
Vorhersagen und Messungen sind jedoch nicht dasselbe. Sobald man keine neuen Daten mehr erfasst, hängt die Qualität der Vorhersage fast ausschließlich von der Qualität der Daten ab, die zum Trainieren des Modells verwendet wurden.
Die allgemeine Regel: Eine Vorhersage ist nur so gut wie ihre Referenzdaten
Im maschinellen Lernen bezeichnet „Ground Truth“ die verifizierten Daten, anhand derer ein Modell trainiert und anhand derer es getestet wird. Einfach ausgedrückt handelt es sich dabei um die richtige Antwort, an der das Modell seine „Antworten“ ausrichtet. In der verhaltensorientierten KI stammen die „Ground Truth“-Daten von echten Menschen. Dazu gehören Informationen darüber, wohin die Menschen geschaut haben, wie sich ihre Gesichter bewegt haben und wie das Publikum reagiert hat.
Wenn ein System Verhalten misst, bleibt es mit der Realität verbunden. Eine reale Person erzeugt die Daten in Echtzeit. Ein prädiktives System funktioniert anders. Es leitet eine Antwort aus Mustern ab, die in historischen Daten von Menschen gefunden wurden. Es ist kein Teilnehmer anwesend, der Fehler korrigieren oder aufzeigen könnte, wo das Modell falsch liegt.
Aus diesem Grund hängt die Vorhersage stark von den tatsächlichen Gegebenheiten ab. Sind die Daten unvollständig, verzerrt, veraltet oder ungenau, spiegeln sich diese Schwächen auch in der Vorhersage wider.
Daraus ergibt sich eine einfache Regel: Je weniger ein Modell misst, desto stärker hängt es von den menschlichen Daten ab, auf denen es aufgebaut ist. Der Mensch verschwindet nie aus dem Prozess. Die Daten rücken lediglich weiter in den Vorfeldbereich.
Fall 1: Vorhergesagte Aufmerksamkeit
Beim prädiktiven Eye-Tracking wird geschätzt, wohin Menschen wahrscheinlich blicken werden, ohne dass tatsächliche Betrachter gemessen werden. Das macht diese Methode schnell, skalierbar und kostengünstig. Es wirft jedoch auch eine wichtige Frage auf: Woher weiß das Modell, wohin die Menschen blicken werden?
Die Antwort lautet: Die KI hat anhand echter Eye-Tracking-Daten gelernt, die bei echten Menschen erhoben wurden. Und die Qualität ihrer Vorhersagen hängt von der Qualität dieser Daten ab.
Die in diesem Forschungsbereich üblichen Benchmark-Tests verdeutlichen, warum das so ist. Beliebte Datensätze wie MIT300 und CAT2000 enthalten einige hundert bis einige tausend Bilder, die von kleinen Teilnehmergruppen mithilfe von Eye-Tracking-Geräten im Labor betrachtet wurden. Ein Modell kann bei diesen Benchmark-Tests beeindruckende Ergebnisse erzielen und dennoch Schwierigkeiten mit einer bestimmten Werbung, einer Produktverpackung oder einer Website haben.
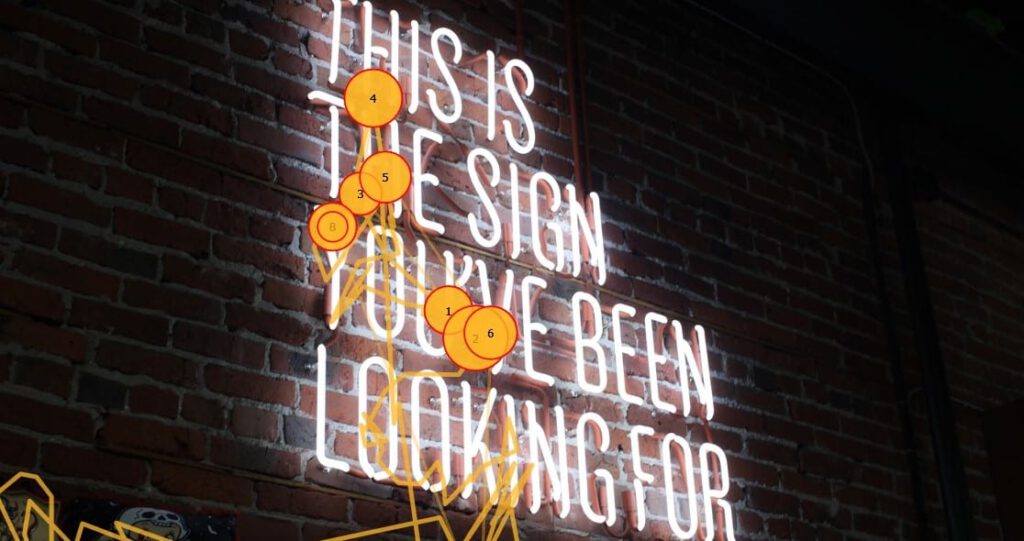
Der Grund dafür ist einfach. Die Bilder in diesen Datensätzen unterscheiden sich oft stark von den Inhalten, die Unternehmen testen möchten. Auch die Aufgaben sind unterschiedlich. Jemand, der sich ein Foto beiläufig ansieht, tut nicht dasselbe wie ein Käufer, der Produkte vergleicht, oder ein Kunde, der versucht, einen Kauf abzuschließen.
Das gleiche Muster zeigt sich auch in den Trainingsdaten. SALICON, einer der am häufigsten verwendeten Datensätze zur Salienz, wurde auf Zehntausende von Bildern skaliert, indem anstelle des herkömmlichen Eye-Trackings ein auf Mausbewegungen basierender Ersatz für die visuelle Aufmerksamkeit verwendet wurde. Zwar korrelieren aus Mausbewegungen abgeleitete Aufmerksamkeitsdaten oft mit dem Blickverhalten, doch haben Studien, die Maus- und Eye-Tracking-Daten verglichen haben, gezeigt, dass die Wahl der Referenzdaten sowohl die im Datensatz erfassten Muster als auch das Verhalten der darauf trainierten Modelle beeinflusst.
Mit anderen Worten: Das Fachgebiet gewann durch die Verwendung eines Ersatzindikators an Bedeutung. Dieser Kompromiss ermöglichte zwar größere Datensätze, machte jedoch echte Eye-Tracking-Daten nicht überflüssig. Er verlagerte diesen Bedarf lediglich weiter in die vorgelagerte Phase.
Die Erkenntnis ist klar: Je genauer die von Menschen ermittelten Referenzwerte sind, desto besser sind die Vorhersagen.
Fall 2: Prognostizierte Zielgruppenbindung, wobei die Referenzdaten das gesamte Produkt darstellen
Das gleiche Muster zeigt sich noch deutlicher bei der Vorhersage des Publikumsengagements.
Traditionell wird das Engagement gemessen, indem Zuschauer rekrutiert, ihnen Inhalte gezeigt und ihre Gesichtsreaktionen von Moment zu Moment analysiert werden. Predictive-Engagement-Modelle verfolgen einen anderen Ansatz: Sie leiten diese Reaktion direkt aus dem Inhalt selbst ab, sodass ein Werbespot getestet werden kann, noch bevor auch nur ein einziger neuer Teilnehmer rekrutiert wurde.
Der Reiz liegt wiederum auf der Hand. Ebenso wie die Abhängigkeit von Daten. Wenn das Modell niemals eine neue Zielgruppe beobachtet, muss alles, was es über das Verhalten von Zielgruppen weiß, von den Zielgruppen stammen, die es bereits gesehen hat.
Das Besondere an diesem Fall ist, dass die „Ground Truth“ und der Wettbewerbsvorteil ein und dasselbe sind. Das Affectiva-Korpus, das über mehr als ein Jahrzehnt hinweg aufgebaut wurde, umfasst mehr als 100.000 Anzeigen, über 18 Millionen Gesichtsdatensätze und Milliarden von Videobildern aus rund 90 Ländern. Entscheidend ist, dass die Annotationen nicht von einem billigen Ersatzdatenbestand stammen.
Sie basieren auf dem Facial Action Coding System (FACS), bei dem geschulte Kodierer bestimmte Gesichtsmuskelbewegungen Bild für Bild auswerten – eine mühsame, fachkundige Arbeit, die den Modellen zugrunde liegt, die als Goldstandard für die automatisierte Gesichtsausdruckskodierung gelten.
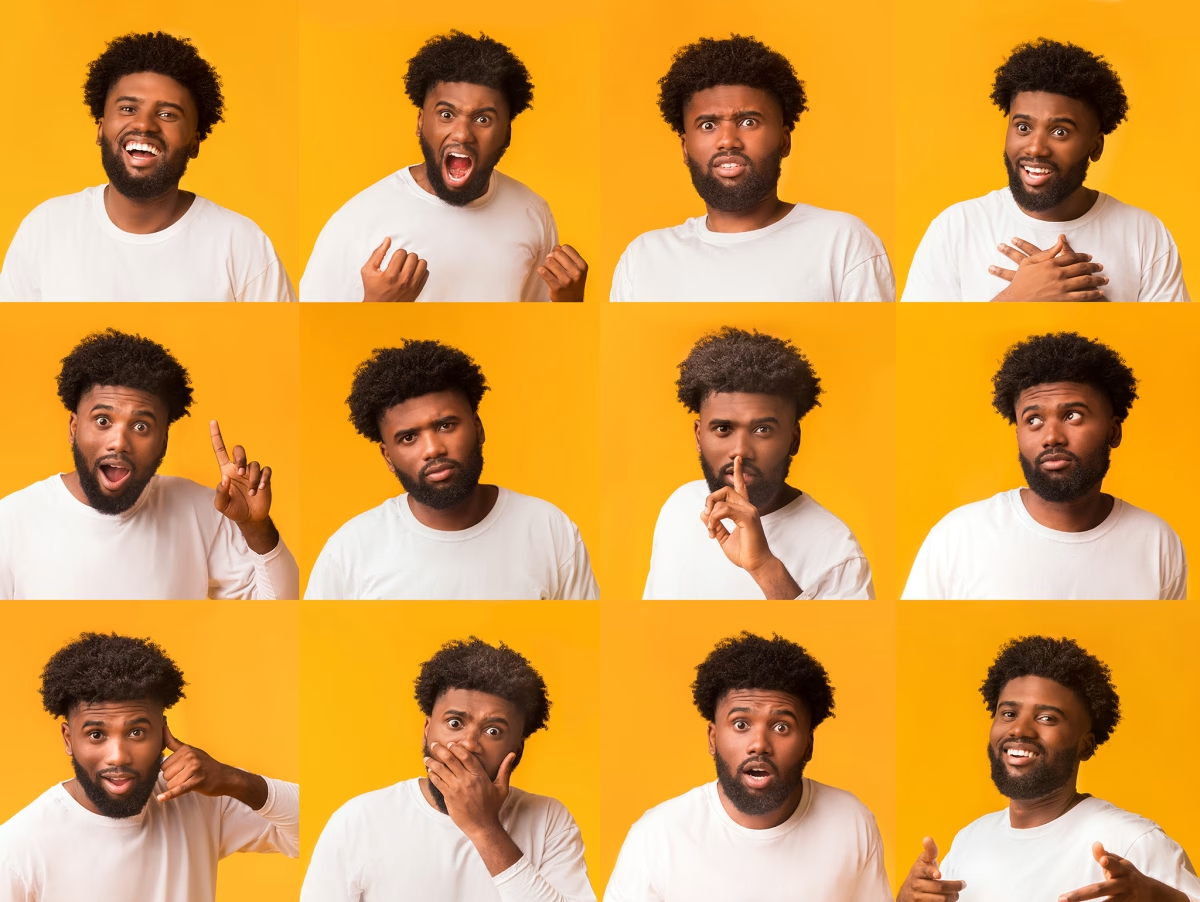
Ein auf diesem Archiv trainiertes prädiktives Interaktionsmodell ist im wahrsten Sinne des Wortes eine Verdichtung einer enormen Menge sorgfältig gekennzeichneter menschlicher Reaktionen. Seine Glaubwürdigkeit beruht auf diesem Korpus.
Dies ist das anschaulichste Beispiel für das allgemeine Gesetz: Das Vorhersagemodell erreicht keine neuen Zuschauer; alles, was es über das menschliche Engagement weiß, weiß es daher nur, weil Menschen gemessen und von menschlichen Experten klassifiziert wurden. Umfang, Vielfalt und die Genauigkeit der Klassifizierung sind keine bloßen „Nice-to-haves“. Sie bilden die gesamte Grundlage des Vertrauens.
Wie eine gute „Ground Truth“ aussieht
An dieser Stelle stellt sich natürlich die Frage: Was unterscheidet ein Vorhersagemodell, das Vertrauen verdient, von einem, das lediglich überzeugend klingt?
Die Antwort liegt nicht in einem einzelnen Benchmark-Ergebnis oder der Größe eines Datensatzes. Bei den verschiedenen Arten von prädiktiver KI tauchen immer wieder dieselben Eigenschaften auf.
Erstens gibt es keinen Ersatz für echte menschliche Daten. Ersatzmaße können nützlich sein und sind manchmal notwendig, um eine große Datenmenge zu erreichen, aber sie sind dennoch nur Ersatz. Ein Modell, das anhand von Mausbewegungen trainiert wurde, ist nicht dasselbe wie ein Modell, das anhand tatsächlicher Blickrichtungsdaten trainiert wurde. Ein Modell, das anhand automatisch generierter Labels trainiert wurde, ist nicht dasselbe wie eines, das anhand sorgfältig kodierten menschlichen Verhaltens trainiert wurde. Wenn es um die Validierung geht, zählt die Realität nach wie vor am meisten.
Auch der Umfang spielt eine Rolle, allerdings nur, wenn er mit Vielfalt einhergeht. Ein Datensatz kann Millionen von Beobachtungen enthalten und dennoch die Menschen, für deren Vorhersage ein Modell gedacht ist, nicht angemessen repräsentieren. Das Ziel sind nicht einfach nur mehr Daten. Das Ziel sind vielfältigere Daten. Verschiedene Kulturen, Altersgruppen, Kontexte und Inhaltstypen tragen alle dazu bei, dass ein Modell ein breiteres Spektrum menschlichen Verhaltens erlernen kann.
Die Qualität der Beschriftungen ist ebenso wichtig wie die Menge der Daten. In vielen Verhaltensbereichen stellen die Beschriftungen praktisch die Definition dessen dar, was „richtig“ bedeutet. Ein FACS-basierter Datensatz ist nicht nur deshalb wertvoll, weil er umfangreich ist, sondern auch, weil geschulte Kodierer Jahre damit verbracht haben, einen einheitlichen und zuverlässigen Bezugspunkt zu schaffen.
Die Daten sollten zudem der Umgebung entsprechen, in der das Modell eingesetzt werden soll. Ein Modell, das anhand generischer Bilder trainiert wurde, schneidet bei Benchmark-Tests zwar gut ab, hat jedoch möglicherweise Schwierigkeiten mit Werbeanzeigen, Websites, Produktverpackungen oder anderen Inhalten aus der realen Welt. Referenzdaten aus dem Zielbereich sind oft wertvoller als ein viel größerer Datensatz aus einer anderen Quelle.
Das Ziel selbst muss zudem messbar sein. Es besteht ein wesentlicher Unterschied zwischen der Vorhersage beobachtbarer Interaktion und der Behauptung, den privaten emotionalen Zustand einer Person lesen zu können. Je näher ein Modell an Dingen bleibt, die beobachtet, gemessen und getestet werden können, desto solider wird seine Grundlage.
Schließlich gibt es noch das Problem der Zeit. Die menschliche Natur ändert sich nicht von heute auf morgen, die Medienlandschaft hingegen schon. Plattformen entwickeln sich weiter. Kreative Stile wandeln sich. Neue Inhaltsformen entstehen. Ein Modell, das auf der Welt von gestern trainiert wurde, kann sich langsam von der heutigen Welt entfernen, wenn seine Referenzdaten nicht im Laufe der Zeit aktualisiert werden.
Insgesamt lassen diese Eigenschaften eine einfache Schlussfolgerung zu: Der Wert eines Vorhersagemodells hängt von der Qualität der ihm zugrunde liegenden menschlichen Realität ab.
Und das führt zu einem interessanten Paradoxon: Je weiter sich vorausschauende KI verbreitet, desto wichtiger wird die menschliche „Ground Truth“.
Je mehr wir vorhersagen, desto mehr brauchen wir menschliche Wahrheit
Wenn man einen Schritt zurücktritt, erkennt man ein klares Muster. Je mehr Vorhersagen an die Stelle von Messungen treten, desto stärker hängt das gesamte System von Daten ab, die von Menschen erhoben und von Menschen gekennzeichnet wurden.
Diese Abhängigkeit taucht an mindestens drei Stellen auf.
Der erste Punkt ist das Training. Jede neue Zielgruppe, Plattform, jede neue Art von Inhalten oder jeder neue Messansatz erfordert letztendlich neue menschliche Daten. Modelle können zwar bemerkenswert gut verallgemeinern, aber sie können nicht unendlich verallgemeinern. Ein Modell, das auf statischen Bildern trainiert wurde, bringt Sie im Bereich Video nur bis zu einem bestimmten Punkt weiter. Ein Modell, das in einem bestimmten kulturellen Kontext trainiert wurde, versteht einen anderen Kontext nicht automatisch. Irgendwann müssen neue menschliche Daten in das System einfließen.
Der zweite Punkt ist die Validierung. Ein Benchmark-Ergebnis mag zwar zeigen, dass ein Modell in einem bestimmten Kontext funktioniert, sagt aber kaum etwas darüber aus, ob es auch für Ihre Zielgruppe oder Ihre Inhalte geeignet ist. Um diese Frage zu beantworten, müssen nach wie vor reale Personen untersucht und die Vorhersagen mit der Realität verglichen werden. Jede ernsthafte Validierung schafft neue Referenzdaten genau an dem Ort, an dem das Modell eingesetzt werden soll.
Der dritte Bereich betrifft die Bereiche, in denen Vorhersagesysteme nach wie vor Schwierigkeiten haben: interkulturelle Unterschiede. Aufgabenorientierte Aufmerksamkeit. Dynamische Inhalte. Die schwierige Beziehung zwischen beobachtbarem Verhalten und inneren emotionalen Zuständen. Viele der größten Herausforderungen in diesem Bereich lassen sich auf begrenzte, umstrittene oder unvollständige Referenzdaten zurückführen. Und viele der besten Lösungen erfordern die Erhebung umfangreicherer und repräsentativerer Daten über das menschliche Verhalten.
Bei aller Aufmerksamkeit, die Algorithmen zuteilwird, ist dies die entscheidende Abhängigkeit. Die Automatisierung der Ergebnisse macht die menschliche Wahrheit nicht überflüssig. Sie steigert vielmehr ihren Wert.
Je erfolgreicher prädiktive KI wird, desto wertvoller werden gleichzeitig hochwertige Referenzdaten.
In einem Bereich, der auf Vorhersagen basiert, sind die umfangreichsten, breitesten und sorgfältigsten beschrifteten Datensätze mit menschlichen Daten nicht nur ein unvermeidbarer Kostenfaktor. Sie bilden das Fundament, auf dem das System ruht, und sind oft der Vorteil, den Wettbewerber nicht ohne Weiteres nachahmen können.
Ein bequemer Vorwand, aber eine echte Abhängigkeit
Man kann zu Recht darauf hinweisen, dass dieses Argument für Unternehmen wie iMotions, die Daten zum menschlichen Verhalten erheben und auswerten, von Vorteil ist. Es ist zwar von Vorteil, aber das macht es noch lange nicht falsch.
Die Abhängigkeit ist struktureller Natur, nicht kommerzieller. Ein Vorhersagemodell, das niemals einen lebenden Teilnehmer misst, hat nur eine einzige Quelle der Wahrheit: die menschlichen Daten, mit denen es trainiert und getestet wurde. Diese Wahrheit kann von keiner anderen Quelle stammen.
Wenn überhaupt, dann untermauern Kritikpunkte wie die von Barrett dieses Argument. Wenn sich menschliches Verhalten je nach Kultur, Kontext und Individuum stärker unterscheidet, als wir einst glaubten, dann gewinnt die Qualität der zugrunde liegenden Daten noch mehr an Bedeutung.
Die Lösung besteht nicht darin, weniger Referenzdaten zu haben. Die Lösung besteht darin, bessere Referenzdaten zu haben. Umfassendere. Vielfältigere. Repräsentativere und sorgfältiger beschriftete.
Die Interessen und das Argument mögen in dieselbe Richtung weisen. Das beweist das Argument zwar nicht. Aber es schwächt es auch nicht.
Diese Abhängigkeit besteht unabhängig davon, ob sie wirtschaftlich sinnvoll ist oder nicht.
Die Vorhersage mag zwar die Messung automatisieren, aber sie kann nicht die Realität automatisieren, aus der die Messung hervorgegangen ist.