
Table of Contents
近年、人を直接測定しないAIツールがますます増えています。その代わりに、これらのシステムはコンテンツそのものから人間の行動を予測します。実在する人の視線や顔の反応を追跡するのではなく、その反応がどのようなものになる可能性が高いかを推定するのです。
この変化は極めて有用です。これにより、テストがより迅速かつ低コストになり、拡張も容易になります。しかし、同時に「信頼」の源泉も変わります。プロセスに実際の参加者が存在しない場合、モデルが現実と結びつくのは、人間によってラベル付けされた学習データという一点のみとなります。
予測AIが普及するにつれて、大規模で多様性があり、質の高い人間に関するデータセットの必要性がなくなるわけではありません。多くの場合、その重要性はさらに高まっています。最も優れたグラウンドトゥルースデータを保有する組織こそが、長期的に見て最大の優位性を握ることになるでしょう。
「予測」が「測定」に取って代わりつつある
行動研究は、その歴史の大部分において、実在する人々を対象とした測定に依存してきました。研究者たちは参加者を募集し、その行動を記録し、サンプル全体にわたって結果を分析してきました。
今日、多くのAIシステムは異なる仕組みで動作しています。人を評価するのではなく、その人がどのような行動をとる可能性が高いかを予測するのです。
広告をアップロードすると、どこに注目が集まるかという予測結果を確認できます。一部のシステムでは、参加者にコンテンツを一切表示することなく、視聴者のエンゲージメントを推定します。
現在、視線追跡や顔の反応、その他の行動形態についても、同様の手法が存在する。
その魅力は明らかです。かつては数週間かかっていた調査も、今では数分で済むようになりました。たった1つの調査プロジェクトを開始する前に、何百ものクリエイティブなコンセプトを精査することができるようになりました。
しかし、予測と測定は同じものではありません。新しいデータの収集を停止すると、予測の精度は、モデルを学習させるために使用されたデータの質にほぼ完全に左右されることになります。
大原則:予測の精度は、その「グラウンドトゥルース」の精度に左右される
機械学習において、「グラウンド・トゥルース」とは、モデルが学習し、その性能を評価するために用いられる検証済みのデータを指します。簡単に言えば、モデルが自身の「答え」を照らし合わせようとする「正解」のことです。行動AIにおいては、グラウンド・トゥルースは実在の人々から得られます。これには、人々の視線の向き、顔の動き、そして観客の反応などが含まれます。
システムが行動を測定する場合、それは現実と結びついたままです。実在する人間がリアルタイムでデータを生み出しています。一方、予測システムは異なる仕組みで機能します。それは、過去の人的データに見られるパターンから答えを導き出します。そこで、誤りを正したり、モデルのどこが間違っているかを指摘したりする参加者は存在しません。
このため、予測は「グラウンドトゥルース」に大きく依存します。データが限定的、偏りがある、古くなっている、あるいは不正確である場合、予測にはそうした弱点が反映されてしまいます。
ここから、ある単純なルールが導き出されます。モデルが測定する項目が少ないほど、そのモデルは構築の基礎となった人間のデータに依存する度合いが高くなります。このプロセスから人間が消えることは決してありません。データが単に、より上流へと移動するだけです。
事例1:予測アテンション
予測型アイトラッキングは、実際の視聴者を測定することなく、人々がどこを見る可能性が高いかを推定します。そのため、処理が高速で、拡張性が高く、低コストです。しかし、それには重要な疑問も生じます。つまり、モデルはどのようにして人々がどこを見るかを予測しているのでしょうか?
その答えは、このAIが実際の人々から収集された実際の視線追跡データから学習したからです。そして、その予測の精度は、そのデータの質に左右されます。
この分野独自のベンチマークを見れば、その理由がわかるでしょう。MIT300やCAT2000といった一般的なデータセットには、実験室でアイトラッカーを使用する少人数の参加者が閲覧した数百から数千枚の画像が含まれています。モデルはこうしたベンチマークでは優れたスコアを記録しても、特定の広告や製品パッケージ、ウェブサイトに対しては依然として苦戦することがあります。
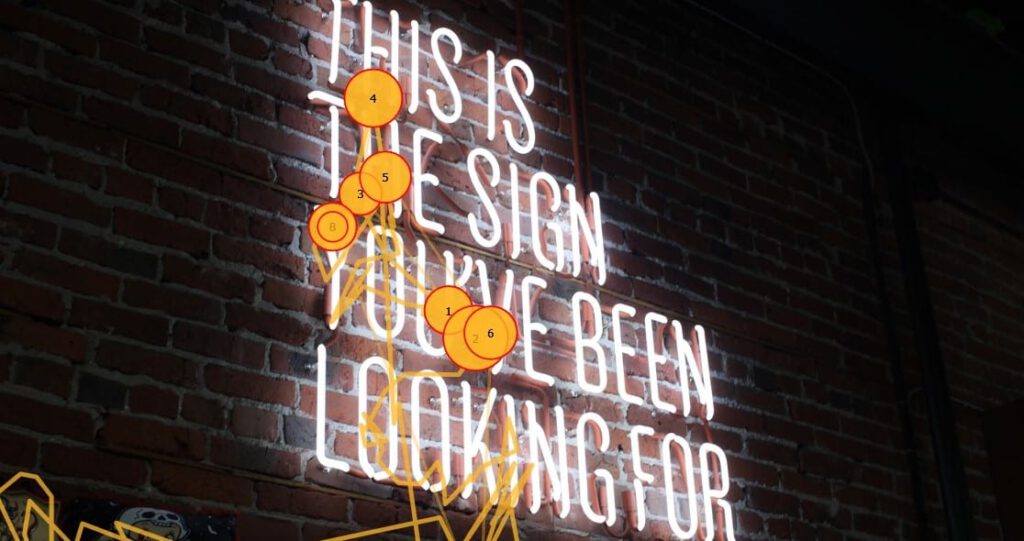
その理由は単純です。これらのデータセットに含まれる画像は、企業がテストしたいコンテンツとは大きく異なる場合が多いからです。タスクも異なります。写真を何気なく眺めている人と、商品を比較している買い物客や、購入を完了しようとしている顧客とでは、行っていることが異なるのです。
トレーニングデータにも同様の傾向が見られる。最も広く利用されているサリエンシーデータセットの一つであるSALICONは、従来のアイトラッキングではなく、マウスの動きを視覚的注意の代用指標として用いることで、数万枚規模の画像データに拡張された。 マウス操作から得られる注目データは、多くの場合、視線行動と相関関係にあるものの、マウス操作データとアイトラッキングデータを比較した研究によると、グラウンドトゥルースの選択は、データセットに捉えられたパターンと、それに基づいて学習されたモデルの挙動の両方に影響を与えることが示されている。
つまり、この分野はプロキシを活用することで規模を拡大した。このトレードオフによって、より大規模なデータセットの構築が可能になったが、実際の視線追跡データの必要性がなくなったわけではない。単に、その必要性が開発プロセスのより初期の段階に移っただけである。
この教訓は単純明快です。より正確な人間のグラウンドトゥルースがあれば、より精度の高い予測が可能になります。
事例 2:予測されるユーザーのエンゲージメント。この場合、グラウンドトゥルースは製品全体である。
この傾向は、視聴者のエンゲージメント予測において、さらに明確に現れています。
従来、エンゲージメントは、視聴者を募集し、コンテンツを提示し、その瞬間の表情反応を分析することで測定されてきました。予測エンゲージメントモデルはこれとは異なるアプローチを採用しています。つまり、コンテンツそのものから直接その反応を推定することで、新たな参加者を1人も募集することなく、クリエイティブを事前に検証することを可能にするのです。
その魅力は、やはり明らかです。データへの依存度も同様です。もしモデルが新しい視聴者を一度も観察したことがない場合、視聴者の行動に関する知識はすべて、これまでに観察した視聴者から得たものに限られることになります。
この事例が際立っている点は、グラウンドトゥルースと競争優位性が同一の資産であることです。10年以上にわたって構築されてきたAffectivaのコーパスは、約90カ国にわたる10万件以上の広告、1,800万件以上の顔データ、そして数十億フレームの動画データで構成されています。 重要なのは、そのラベルが安価な代用データに由来していないという点です。
これらは「顔面動作コーディングシステム(FACS)」に基づいており、訓練を受けた人間のコーダーが特定の顔面筋の動きを1フレームずつ注釈付けています。この丹念で専門的な人的作業こそが、自動顔面コーディングのゴールドスタンダードと見なされているモデルの基盤となっているのです。
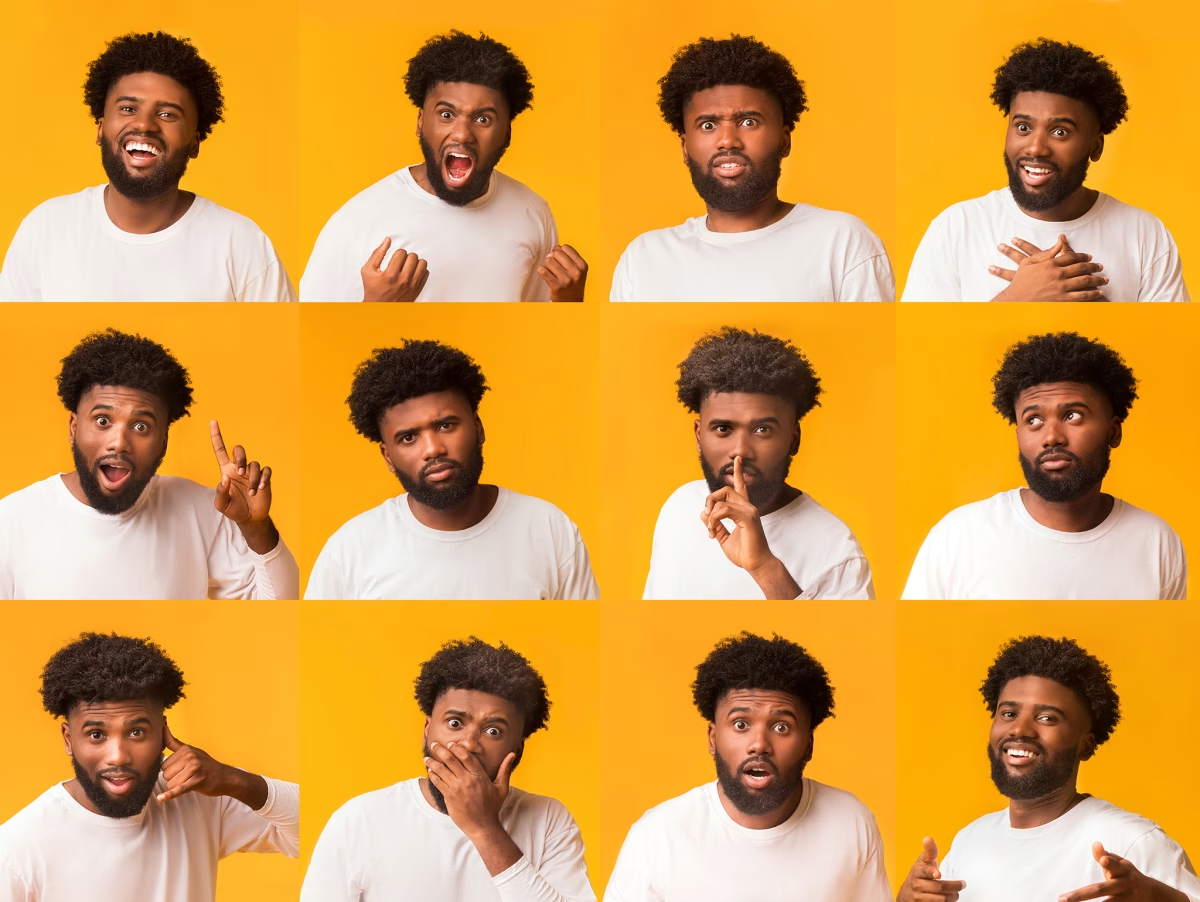
そのアーカイブを用いて学習された予測エンゲージメントモデルは、最も文字通りの意味で、慎重にラベル付けされた膨大な量の人間の反応を凝縮したものである。その信頼性の根拠は、そのコーパスそのものである。
これは、この一般法則を最も明確に示す例です。予測モデルは新たな視聴者に接触することはないため、人間のエンゲージメントに関するあらゆる知識は、人間を測定し、専門家がそれらにラベル付けを行った結果として得られたものです。規模、多様性、そしてラベル付けの厳密さは、単なる「あれば望ましい」要素ではありません。それらは信頼の根幹そのものなのです。
「良質なグラウンドトゥルース」とはどのようなものか
ここで、当然の疑問が浮かび上がります。信頼に値する予測モデルと、単に説得力があるように聞こえるだけのモデルとを、何が区別しているのでしょうか?
その答えは、単一のベンチマークスコアやデータセットの規模にあるわけではありません。さまざまな種類の予測AIにおいて、同じ資質が繰り返し見られます。
まず、実際の人間のデータに代わるものはありません。代用指標は有用であり、規模を拡大するために必要な場合もありますが、あくまで代用品に過ぎません。マウスの動きで学習させたモデルは、実際の視線データで学習させたモデルとは異なります。 自動生成されたラベルを用いて学習させたモデルは、慎重にコード化された人間の行動を用いて学習させたモデルとは同じではありません。検証の段階において、やはり現実が最も重要となります。
データの規模も重要ですが、それは多様性が伴っている場合に限ります。データセットには数百万件の観測値が含まれていても、モデルが予測対象とする人々を適切に代表できていない場合があります。目標は単にデータ量を増やすことではありません。目標は、より幅広いデータを確保することです。異なる文化、年齢層、状況、コンテンツの種類はすべて、モデルがより幅広い人間の行動を学習するのに役立ちます。
ラベルの質は、データの量と同じくらい重要です。多くの行動分野において、ラベルは事実上、「正しい」とは何かを定義するものです。FACSに基づくデータセットが価値あるのは、その規模が大きいからだけでなく、訓練を受けた人間のコーダーが何年もかけて、一貫性があり信頼性の高い基準点を作り上げたからでもあります。
また、データはモデルが実際に使用される環境に類似している必要があります。一般的な画像で学習されたモデルは、ベンチマークでは良好な性能を発揮しても、広告、ウェブサイト、製品のパッケージ、その他の実世界のコンテンツではうまく処理できない場合があります。対象ドメインのグラウンドトゥルースは、他の場所から得られたはるかに大規模なデータセットよりも、多くの場合、より価値があります。
目標そのものも測定可能でなければなりません。観察可能なエンゲージメントを予測することと、他者の内面的な感情状態を読み取ると主張することとの間には、重要な違いがあります。モデルが、観察・測定・検証可能な事象に忠実であればあるほど、その基盤は強固なものとなります。
最後に、時間という問題があります。人間の本性は一夜にして変わるものではありませんが、メディア環境は変化します。プラットフォームは進化し、クリエイティブなスタイルは変わり、新しい形式のコンテンツが登場します。昨日の世界に基づいて学習されたモデルは、そのグラウンドトゥルースが随時更新されない限り、徐々に今日の世界からかけ離れていくことになります。
これらの特性を総合すると、一つの単純な結論が導き出される。予測モデルの価値は、その根底にある人間の現実の質に依存するのだ。
そして、そこには興味深いパラドックスが生まれます。予測型AIが普及すればするほど、人間による「グラウンド・トゥルース」の重要性は高まるのです。
予測すればするほど、人間の真実が必要になってくる
一歩引いて見てみると、明確な傾向が見えてきます。予測が測定に取って代わる割合が高まるほど、システム全体は人間によって収集・ラベル付けされたデータへの依存度を高めていくのです。
この依存関係は、少なくとも3か所で確認されます。
第一に、トレーニングです。 新しい対象層、プラットフォーム、コンテンツの種類、あるいは測定手法には、いずれ新しい人間によるデータが必要となります。モデルは驚くほど優れた汎化能力を持っていますが、いつまでも汎化できるわけではありません。静止画像で学習されたモデルでは、動画の分野では限界があります。ある文化的文脈で学習されたモデルが、別の文化的文脈を自動的に理解できるわけではありません。ある時点で、新しい人間によるデータをシステムに取り入れる必要があります。
2つ目は検証です。ベンチマークスコアは、モデルがどこかで機能することを示しているかもしれませんが、それが対象ユーザーやコンテンツに対して機能するかどうかについてはほとんど何も語っていません。その疑問に答えるには、依然として実在の人々を対象に測定を行い、予測と現実を比較する必要があります。真剣な検証作業を行うたびに、そのモデルが実際に使用されるはずの場所で、新たな「グラウンドトゥルース」が生み出されるのです。
3つ目は、予測システムが依然として苦戦している分野、すなわち異文化間の違いです。 タスク主導型の注意。動的なコンテンツ。観察可能な行動と内面の感情状態との間の複雑な関係。この分野における最大の課題の多くは、限定的、議論の余地がある、あるいは不完全な「グラウンド・トゥルース(実測データ)」に起因しています。そして、最良の解決策の多くは、より豊富で代表性の高い人間データの収集を伴うものです。
アルゴリズムがこれほど注目されているとはいえ、最も重要なのはこの依存関係です。出力を自動化しても、人間による「真実」の必要性がなくなるわけではありません。むしろ、その価値を高めるのです。
予測AIの精度が高まるほど、それに伴い高品質なグラウンドトゥルースの価値も高まっていく。
予測を基盤とする分野において、最も深く、広範で、かつ入念にラベル付けされた人間のデータセットは、単なる事業運営上のコストではありません。それらはシステムを支える基盤であり、多くの場合、競合他社が容易に真似できない優位性そのものなのです。
都合の良い議論だが、実際には依存関係がある
この主張は、iMotionsのような、人間の行動データを収集・分類する企業にとっては都合の良いものであると指摘するのは妥当だろう。都合が良いとはいえ、だからといってそれが間違っているわけではない。
この依存関係は構造的なものであり、商業的なものではありません。実際の参加者を一度も測定したことのない予測モデルにとって、唯一の「真実の源」は、そのモデルの学習および検証に用いられた人間に関するデータだけです。その「真実」が他から得られる余地は一切ありません。
むしろ、バレットのような批判は、この主張を裏付けるものとなる。もし人間の行動が、かつて考えられていたよりも文化や状況、個人によって大きく異なるのであれば、その根拠となるデータの質はさらに重要になる。
答えは、グラウンドトゥルースの量を減らすことではありません。より質の高いグラウンドトゥルースを確保することです。より広範で、より多様で、より代表性が高く、そしてより入念にラベル付けされたものにすることです。
その関心と論点は、同じ方向を指し示しているかもしれない。だからといって、その論点が正しいことを証明するわけではない。しかし、その論点を弱めるわけでもない。
その依存関係は、商業的に都合がよいかどうかに関わらず存在する。
予測によって測定は自動化されるかもしれないが、その測定の根拠となった現実そのものを自動化することはできない。